

Рейтинг аудитории: 27 моделей ИИ, ChatGPT на 8-м месте — вот модели, которые его превзошли
Хотя мир искусственного интеллекта (ИИ) часто кажется неспокойной областью, за кулисами происходит удивительно много анализа, измерения производительности и тестирования. Это делают не только сами компании, но и группы, созданные для определения собственных рейтингов.
Эти группы проверяют всё: от способности чат-бота выполнять математические тесты,
Даша, или дать логические объяснения, или даже дать медицинский совет, или просто показать, насколько она эмоциональна.
В ходе этих разнообразных тестов модели выявляют свои сильные и слабые стороны в различных областях. Например, хотя GPT-5 превосходно справляется с научными выводами, она отстает от таких моделей, как Gemini и Claude, в своей способности адаптироваться к новым концепциям.
Каждый из этих тестов даёт нам что-то новое о моделях ИИ и важен для понимания того, какие инструменты лучше всего подходят для разных сценариев. Но часто упускается один важный показатель: какие модели ИИ обеспечивают наилучший пользовательский опыт?
Система классификации человека
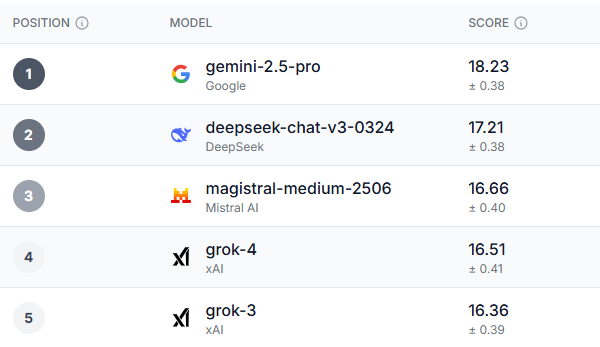
Британская технологическая компания Prolific создала рейтинг ИИ под названием Humaine . Вместо проверки способности ИИ выполнять задачи, Prolific тестировала различные варианты взаимодействия пользователей с этими моделями.
Оценив опыт 21 352 человек с помощью инструментов, они не только смогли выявить общего победителя, но и разбить результаты по возрасту, местоположению (тестирование проводилось как в Великобритании, так и в США) и политическим убеждениям.
Сюда входят отдельные листинги для:
- Великобритания: Возрастные группы
- Соединенное Королевство: Раса
- Соединенное Королевство: политическая точка зрения
- Соединенные Штаты: Возрастные группы
- Соединенные Штаты: Раса
- Соединенные Штаты: политическая точка зрения
Команда попросила каждого участника взаимодействовать с двумя отдельными моделями ИИ для сравнения и попросила их предоставить обратную связь о том, какая модель показала лучшие результаты в каждом взаимодействии.
В результате был выявлен общий победитель и составлена таблица лидеров по производительности, а также отдельные рейтинги по основным показателям выполнения задач и логическому мышлению, а также победитель по показателям коммуникабельности, устойчивости, доверия и этики.
Что показывают результаты?
После тщательного анализа был выявлен явный победитель не только в категории общей производительности, но и в большинстве подкатегорий. Gemini 2.5-Pro превзошёл все ожидания практически во всех рассмотренных тестах.
Молодые люди в возрасте 18-34 лет в Великобритании, избиратели-демократы и люди старше 55 лет в США сошлись во мнении, что Gemini 2.5 Pro — лучшая модель в целом. Единственная область, где все демографические группы оценили её выше, чем Gemini, — это доверие, этика и безопасность, и это Grok-3 — несколько ироничный результат, учитывая некоторые проблемы безопасности и этики, с которыми эта модель ИИ недавно столкнулась.
Интересно, что после Gemini появились три модели: Deepseek, Magistral Le Chat и Grok . Deepseek пользовался значительной популярностью в начале этого года, но в последнее время его популярность снизилась. Le Chat, напротив, менее популярен, но имеет преданных поклонников.
Так какое же место во всем этом занимает всемирно известный ChatGPT? Он находится в самом низу списка, занимая восьмое место со своей топовой моделью GPT-4.1. Еще хуже обстоят дела у Claude , чьи две версии (4.0 и 4.0) заняли одиннадцатое и двенадцатое места в общем рейтинге.
Так что же все это значит?
Означает ли это, что Gemini — лучший чат-бот с искусственным интеллектом в мире? Означает ли это, что вам стоит отказаться от ChatGPT…? Ну, не совсем.
Эти результаты не обязательно отражают эффективность этих моделей. При тестировании по большинству других показателей на первых позициях обычно оказываются ChatGPT, Gemini, Claude и Grok.
Тем не менее, это важное дополнение к этим тестам. Они помогают нам лучше понять ИИ с точки зрения человеческого опыта. Например, Le Chat не показывает высоких результатов по стандартным тестам, но его часто называют отличным выбором с точки зрения опыта и надёжности.
Хотя производительность Anthropic и OpenAI в этом раунде тестов не достигла такого уровня, Gemini и Grok продемонстрировали ещё один сильный результат. Обе компании часто добиваются высоких результатов в стандартных бенчмарках, и здесь они продолжают это делать.
Комментарии закрыты.